Kokoro:开放权重的轻量语音合成模型
内容摘要
Kokoro 可以把文字生成旁白,适合准备配音素材或为自己的工具接入朗读功能。它是需要运行环境的开放权重模型,支持选择语言、音色、语速,并将长文分段生成 WAV 音频。普通话需要相应语言扩展;模型权重采用 Apache-2.0 许可,第三方托管服务的费用另计。
1. 为文字生成旁白
给视频批量配旁白,或者在自己开发的工具里加入朗读功能时,往往需要一个可以自行部署的语音合成方案。Kokoro(Kokoro-82M)是一个参数量为 8200 万的开放权重文字转语音(TTS)模型,配套提供 Python 推理库 kokoro。
它不是带图形界面的桌面剪辑软件,需要在 Python 环境或 Google Colab 中调用运行。把运行环境配置好后,通过初始化 KPipeline 就能把输入的文本转换成采样率 24000 Hz 的音频数据。
2. 选择语言和音色
初始化推理管道时,通过 lang_code 参数指定合成语言,并需确保所选音色与语言代码相匹配:
- 英语与欧洲语言:支持美式英语(
a)、英式英语(b)、西班牙语(e)、法语(f)、意大利语(i)和巴西葡萄牙语(p)。 - 普通话与日语:使用普通话(
z)或日语(j)时,除了基础库之外,还需要分别安装misaki[zh]或misaki[ja]语言扩展。
3. 调整语速,分段生成音频
在实际生成旁白时,推理管道提供了几个直接影响输出效果的参数,方便把长文处理成可直接使用的音频文件:
- 切换音色与加载权重:可以在调用
pipeline时传入音色名称(如voice='af_heart')。 - 调节语速与按段切分:通过
speed参数调整朗读快慢(如设为1),并用split_pattern(如r'\n+')按换行符自动把长文本拆分成多个片段依次生成。 - 逐段导出文件:生成器会按顺序返回每一段的序号、原始文本、音素以及音频数据,配合
soundfile库就能把每个段落分别保存为独立的.wav音频文件。
4. 自行部署或使用托管服务
Kokoro 的模型权重采用 Apache-2.0 许可证发布,个人项目、科研或商业生产环境都可以免费下载部署。如果你不想自己在本地或云端配置 Python 环境,也可以先通过 Hugging Face 上的官方在线空间试听和体验;部分第三方云平台也提供了托管的商业 API,这类托管服务会按各平台标准计费。
图片预览
资料来源
免费吧编辑设计
Kokoro 项目资料
资料核对于 2026年10月20日
相关资源
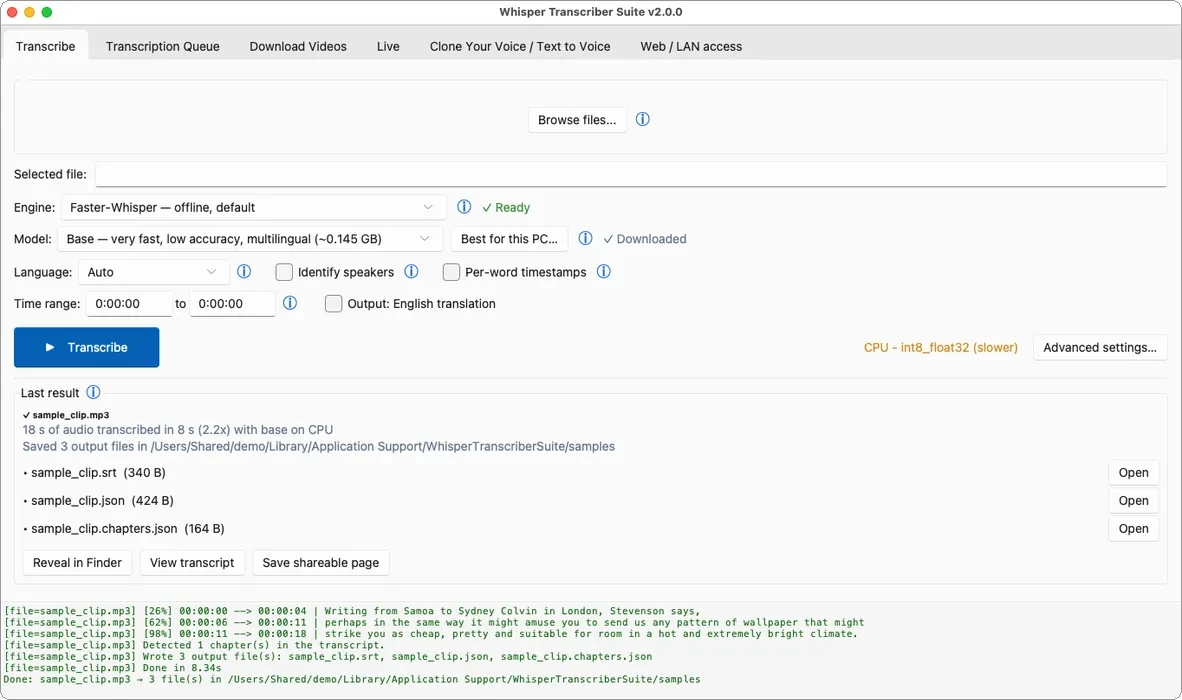
Transub Player:边看视频,边出双语字幕Transub Player 是一款 Windows 播放器,能在播放本地视频时做语音转写和翻译,切换原文、译文或双语字幕,适合没有现成字幕的外语视频。首次使用需要下载识别与翻译模型,准备好后可离线使用。字幕会稍晚于画面出现,也支持通过局域网在手机浏览器里选片观看。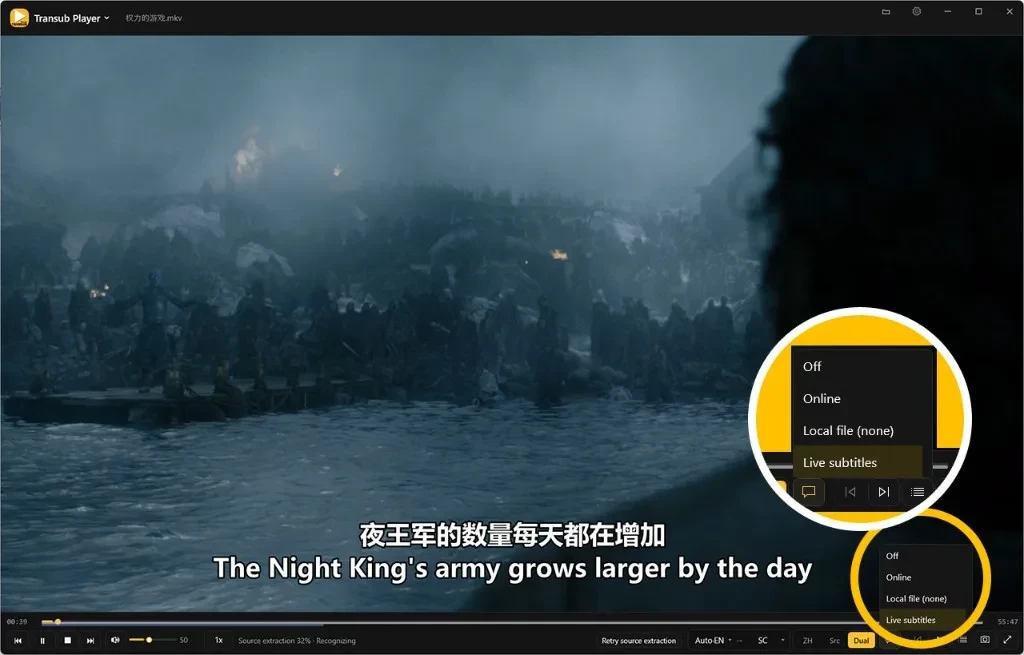 Whisper Transcriber Suite:免费开源的本地录音转文字工具Whisper Transcriber Suite 适合整理访谈、会议录音和视频字幕。下载语音模型后,可以在本机识别音视频、区分说话人,并导出文稿或带时间的字幕;多个文件可排队处理。本地转录不按分钟收费。软件免费开源,提供 Windows、macOS 安装包,Linux 需从源码运行。
 默读 Modu Reader:开源的跨平台电子书阅读器默读适合阅读本地电子书、PDF 和扫描书。可以裁去书页留白,用设备端 OCR 识别并重排文字,边读边查词、划线和记笔记,也能通过自己的 WebDAV 或 S3 存储同步阅读位置。本地阅读无需 AI 账号,在线服务按需配置;iOS 和原生鸿蒙安装包需要自行签名。
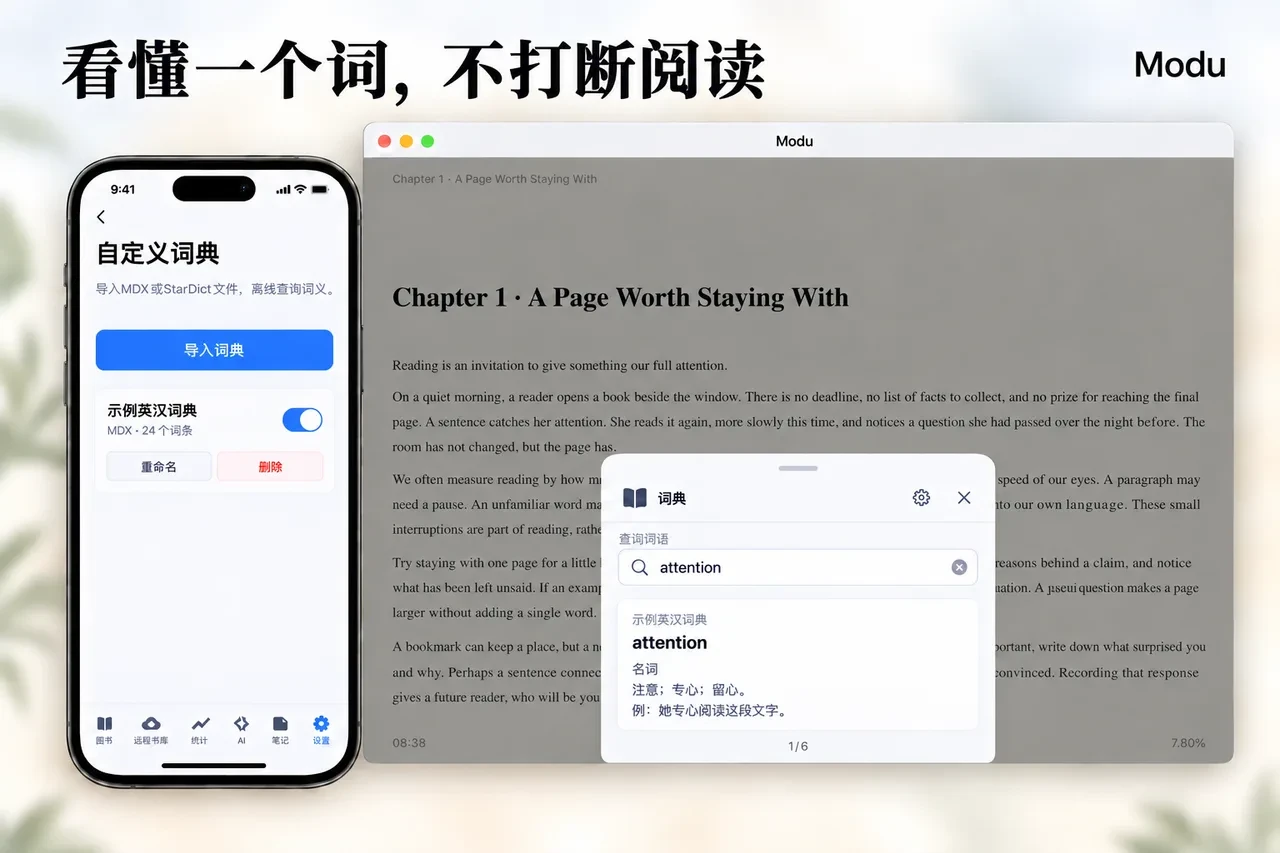
Whisper Transcriber Suite:免费开源的本地录音转文字工具Whisper Transcriber Suite 适合整理访谈、会议录音和视频字幕。下载语音模型后,可以在本机识别音视频、区分说话人,并导出文稿或带时间的字幕;多个文件可排队处理。本地转录不按分钟收费。软件免费开源,提供 Windows、macOS 安装包,Linux 需从源码运行。默读 Modu Reader:开源的跨平台电子书阅读器默读适合阅读本地电子书、PDF 和扫描书。可以裁去书页留白,用设备端 OCR 识别并重排文字,边读边查词、划线和记笔记,也能通过自己的 WebDAV 或 S3 存储同步阅读位置。本地阅读无需 AI 账号,在线服务按需配置;iOS 和原生鸿蒙安装包需要自行签名。