Umi-OCR:免费开源的离线文字识别工具
内容摘要
Umi-OCR 可以离线提取截图、图片和扫描文档中的文字,支持整理多栏文字与换行、批量识别图片、排除固定水印或页眉页脚,还能生成可搜索的 PDF。适合经常摘录资料、整理扫描件的办公用户。软件免费开源,支持 Windows 与 Linux,Windows 版解压即可使用。
1. 提取截图中的文字并整理排版
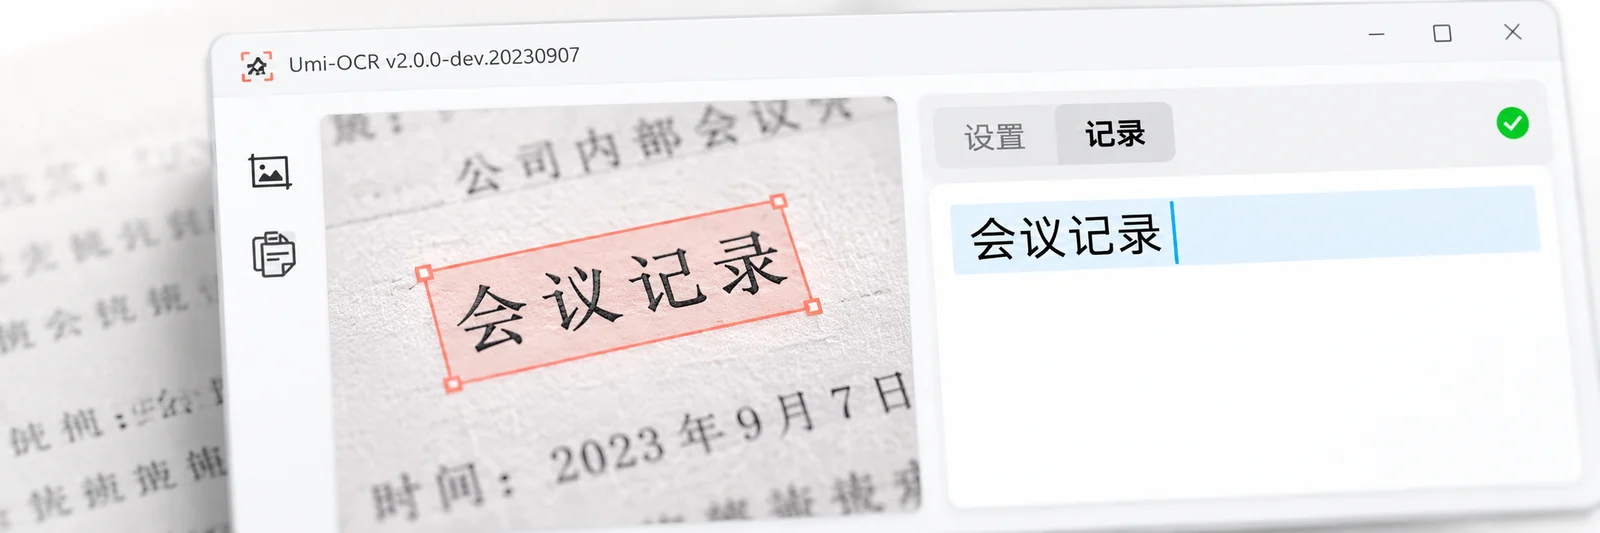
日常办公遇到无法直接复制的网页文字、聊天截图或演示画面,打开 Umi-OCR 的截图 OCR 标签页,就能用快捷键框选屏幕区域,或者直接把剪贴板里的图片粘贴进来识别。界面左侧的图片预览栏支持直接用鼠标划选文字复制,右侧的识别记录栏则可以随时编辑修改,也能一次划选多条记录集中复制。
识别分栏资料或代码截图时,除了文字本身,还需要处理段落顺序、换行和缩进。Umi-OCR 内置了文本后处理排版解析方案,能根据原图布局整理文字顺序,并支持横排和从右到左的竖排文字(竖排需底层 OCR 引擎本身支持):
- 多栏按自然段换行:适合大多数阅读材料,自动区分多栏布局,并按自然段规则整理换行。
- 单栏保留缩进:适合识别代码截图,能保留行首的缩进与行中空格。
- 按需控制换行:多栏和单栏模式下都提供总是换行、无换行(合并到同一行)等选项,也可以选择不做处理,保留引擎原始输出。
2. 批量识别图片并跳过水印文字
面对几百张本地图片或连续截图,批量 OCR 页面没有导入数量上限,支持 jpg、png、webp、bmp、tif 等常见格式,同样可以使用排版解析功能,并支持在任务完成后自动关机或待机。识别结果可导出为 txt、jsonl、md 和 csv(Excel)格式;需要注意的是,导出 csv 只是将识别结果按该格式保存,识别表格图片并还原输出为 Excel 目前仍在远期计划中。如果遇到像素超大的长图或大图,可以在页面设置的文字识别选项里,将限制图像边长的数值调高。
批量处理带有固定角标、Logo 或水印的图片时,可以在右侧设置中打开忽略区域编辑器,按住鼠标右键绘制多个矩形框。这并不是修改原图或去除图片水印,而是让软件在识别时跳过框内的文字,避免无关字符混入结果。由于只有完全处于矩形框内部的整个文本块才会被忽略,画框时需要尽量画大一些,把水印可能出现的位置完整包住,未完全落入框内的文本块则不会被该区域排除。
3. 将扫描文档转为可搜索的 PDF
整理扫描件或电子书时,文档识别页面支持导入 pdf、xps、epub、mobi、fb2 和 cbz 文件。它不仅能直接提取文档里的原有文本或对扫描页面做 OCR 识别,还能将识别结果输出为双层可搜索 PDF。这样既保留了原本的扫描版面,又能按关键词检索、划选复制里面的文字。
文档识别同样支持设置忽略区域和任务完成后自动关机或休眠。如果整本扫描资料的顶部和底部都有固定页眉、页脚或页码,可以设置忽略区域,排除这些位置的重复文字。
4. 离线运行、附加功能与平台支持
Umi-OCR 代码开源且完全免费,适用于 Windows 7 x64 和 Linux x64 系统(macOS 兼容尚在远期计划中)。Windows 下提供 .7z 压缩包或 .7z.exe 自解压包,后者不需要另装解压软件;无需安装,解压后直接运行程序即可。软件支持离线识别,不需要上传图片,适合处理不便上传到云端的内部资料。如果部分机器出现截屏闪烁或界面错位,可以在全局设置的界面和外观中调整渲染器,切换渲染方案或关闭硬件加速。
除了常规文字识别,软件还内置了二维码工具与外部调用接口:
- 二维码识别与生成:支持截图、粘贴或拖入图片读取二维码和条形码,可一图多码识别 QRCode、Code128、EAN13 等 19 种协议;也能输入文本并设置纠错等级来生成二维码图片。
- 插件与外部接口:自带离线 OCR 引擎与多语言识别库,可通过插件切换 Rapid-OCR 或 Paddle-OCR 引擎;同时提供命令行与 HTTP 接口,方便开发者或进阶用户接入自动化流程。
图片预览
资料来源
软件免费
支持商用。
资料核对于 2026年10月17日
相关资源
 ONLYOFFICE Desktop Editors:免费开源的文档与 PDF 编辑器ONLYOFFICE Desktop Editors 可以在同一个窗口用标签页切换文档、表格、演示稿和 PDF。除了离线编辑本地办公文件,也能修改 PDF 文字和图片、批注或填写表单,需要协作时再连接云服务。桌面版免费开源,支持 Windows、macOS 和 Linux。
 默读 Modu Reader:开源的跨平台电子书阅读器默读适合阅读本地电子书、PDF 和扫描书。可以裁去书页留白,用设备端 OCR 识别并重排文字,边读边查词、划线和记笔记,也能通过自己的 WebDAV 或 S3 存储同步阅读位置。本地阅读无需 AI 账号,在线服务按需配置;iOS 和原生鸿蒙安装包需要自行签名。