用 NAPS2 把扫描 PDF 变成可搜索文字
内容摘要
扫描 PDF 只有画面时,NAPS2 可以通过 OCR 添加文字层,让阅读器能够查找和复制内容。先下载对应语言并启用 OCR,再导入或扫描页面,保存为 PDF。适合整理旧资料,不需要把原来的页面重新排版。
- 相关工具
- NAPS2
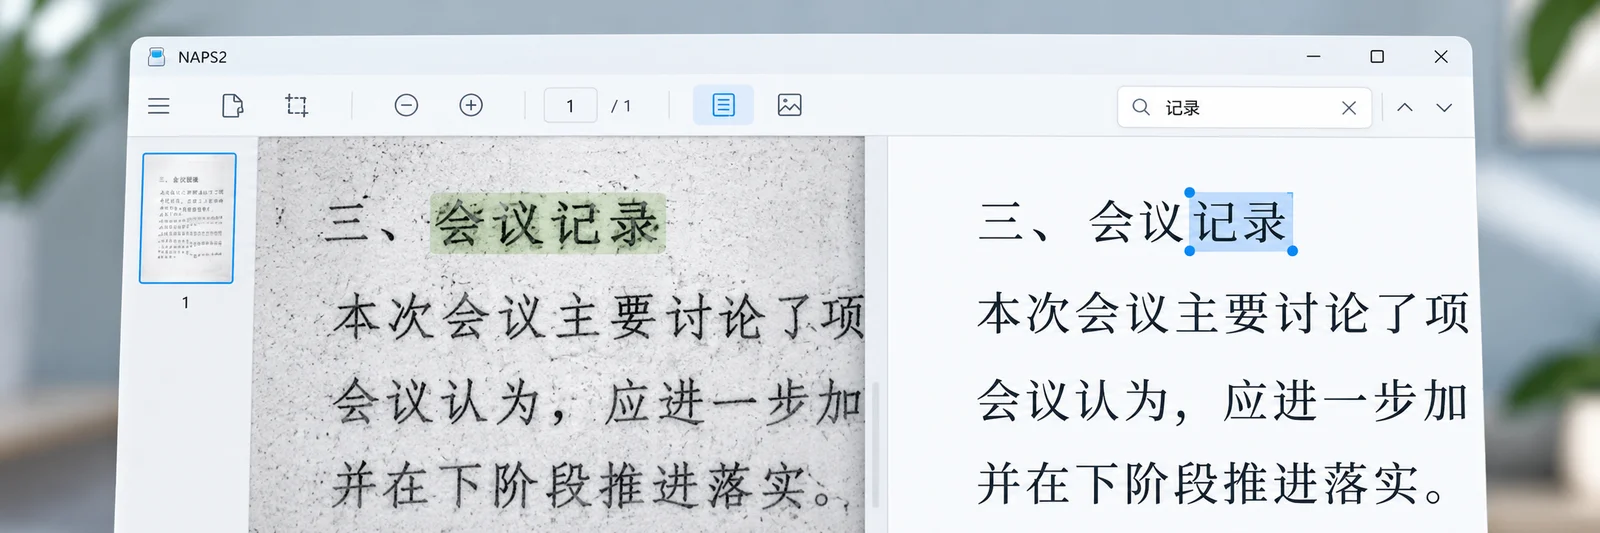
一份扫描 PDF 看着有字,搜索却总是没有结果,往往因为里面只有页面图片。NAPS2 可以给它补上文字层,之后用阅读器查关键词,不必一页页翻。
1. 先把识别语言准备好
打开 NAPS2 的 OCR 设置,首次使用先下载需要的语言。中文资料选对应语言,混合语言文件则按内容选择多语言,不必把所有语言都装上。
确认已开启让 PDF 可搜索的 OCR 选项,再处理文档。
2. 导入扫描件,重新保存 PDF
已有文件可以直接导入,也可以从扫描仪取得页面。检查方向和页序后保存为 PDF,NAPS2 会在保存过程中完成需要的识别。
对于导入的文档,它会保留已经有文字的页面,只对没有文字的页面执行 OCR。整份文件不需要先全部转换成图片。
3. 用阅读器验证结果
打开新保存的 PDF,搜索一处页面里确实存在的词,再试着选中文字。关键名称、金额和编号仍值得核对,尤其是模糊扫描件。
NAPS2 不直接把 OCR 结果另存为纯文本文件。只要文字时,可以从生成的 PDF 中复制;如果要批量提取成文本,Umi-OCR 的输出方式会更符合那个任务。
资料来源
本文由免费吧依据所列资料独立整理。
免费吧编辑设计
用 NAPS2 把扫描版 PDF 做成可以搜索的文件 项目资料
资料核对于 2026年10月18日